当深夜调试Transformer结构的梯度爆炸问题,当多机多卡分布式训练卡在数据加载瓶颈,当本地部署Llama3-70B需要平衡显存容量与PCIe吞吐——AI开发者与研究人员不再仅关注纸面参数,而是真正依赖一块稳定、高带宽、可扩展且软硬协同优化的GPU。他们需要的不是单纯的游戏帧率,而是持续高负载下的计算密度、显存访问效率、FP16/FP8混合精度支持能力,以及CUDA生态的无缝兼容性。在这一背景下,面向科研与工程落地的NVIDIA显卡正成为实验室机柜、边缘推理节点与云边协同平台的核心算力单元。
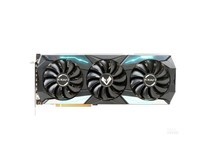
七彩虹iGame GeForce RTX 2060 SUPER Vulcan X OC,到手价3599.0元,是轻量级模型训练与教学实验的理想起点。基于图灵架构,其2176个CUDA核心与8GB GDDR6显存,在ResNet50单卡训练、YOLOv5s微调及Stable Diffusion WebUI本地部署中表现稳健;Vulcan系列强化散热模组与出厂超频设计,保障连续数小时编译与训练不降频,配合NVIDIA Studio驱动,对TensorRT Lite与ONNX Runtime兼容友好,特别适合高校课程实践与个人研究者起步阶段使用。
NVIDIA Tesla A800 80G,到手价103999.0元,代表当前AI基础设施的算力锚点。专为数据中心与高性能计算场景打造,支持PCIe 4.0 x16与NVLink 3.0互联,80GB HBM2e显存提供超1.6TB/s带宽,原生支持FP8张量核心与结构化稀疏加速,在Llama2-70B全参数加载、MoE模型路由计算及大规模推荐系统实时推理中展现出不可替代性;其被动散热+服务器级供电设计,完美适配4U机架环境,是国家级重点实验室、AI研究院及头部科技企业构建私有算力集群的基石型选择。

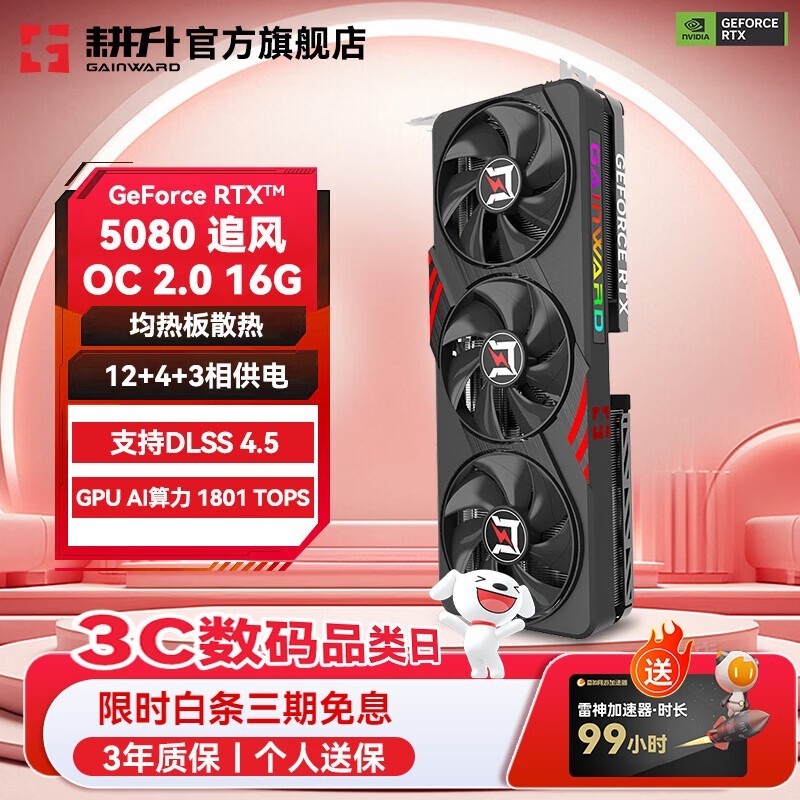
耕升RTX 5080 追风OC,到手价9499.0元,填补了消费级旗舰与专业卡之间的关键空白。依托新一代Ada Lovelace架构,超2800个CUDA核心、16GB GDDR7显存与高达48GB/s的显存带宽,使其在单卡运行Qwen2-14B全量微调、Diffusers库图像生成批处理及NeRF重建任务中游刃有余;第四代散热系统集成VC均热板与三风扇阵列,满载表面温度控制在72℃以内;DLSS 4帧生成技术更首次将AI超分引入科学可视化渲染流程,大幅提升三维仿真结果交互响应速度。对于预算有限但需兼顾算法验证与原型交付的AI初创团队,它提供了极具张力的性能-成本比。

从课堂实验到百亿参数模型训练,从单卡微调到多节点协同推理,这三款N卡显卡以清晰的定位分层覆盖AI开发者全周期需求:入门可控、中坚可靠、旗舰可扩展。它们不只是图形处理器,更是代码之外最沉默而坚定的协作者。
本文属于原创文章,如若转载,请注明来源:N卡显卡热卖排行榜 支持FP8/INT4量化加速的科研显卡集https://diy.zol.com.cn/1256/12569024.html